Sémantické vyhledávání v historických archivech pomocí AI
Paměť novin je inovativní aplikace navržená pro pokročilé vyhledávání a analýzu historických periodik z přelomu 19. a 20. století. Na rozdíl od běžných fulltextových vyhledávačů, které pracují pouze s přesnou shodou klíčových slov, využívá tento systém velké jazykové modely (LLM) k pochopení významu a kontextu dotazu. Uživatelům tak umožňuje objevovat události, vztahy a dobové souvislosti přirozeným jazykem, čímž výrazně zefektivňuje práci s rozsáhlými digitálními archivy.
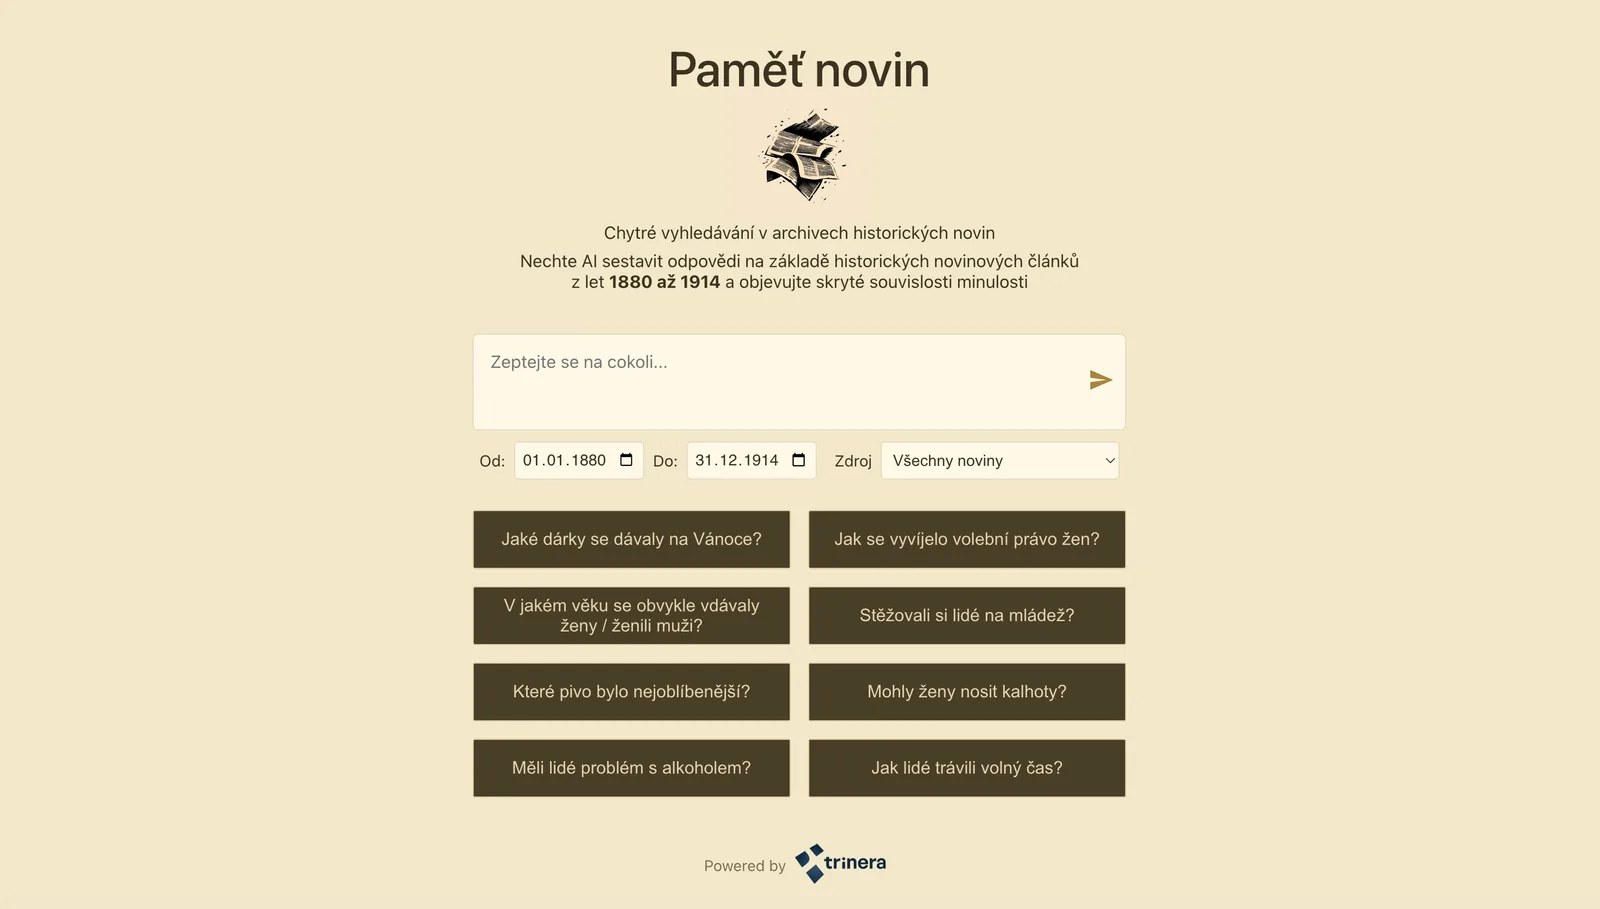
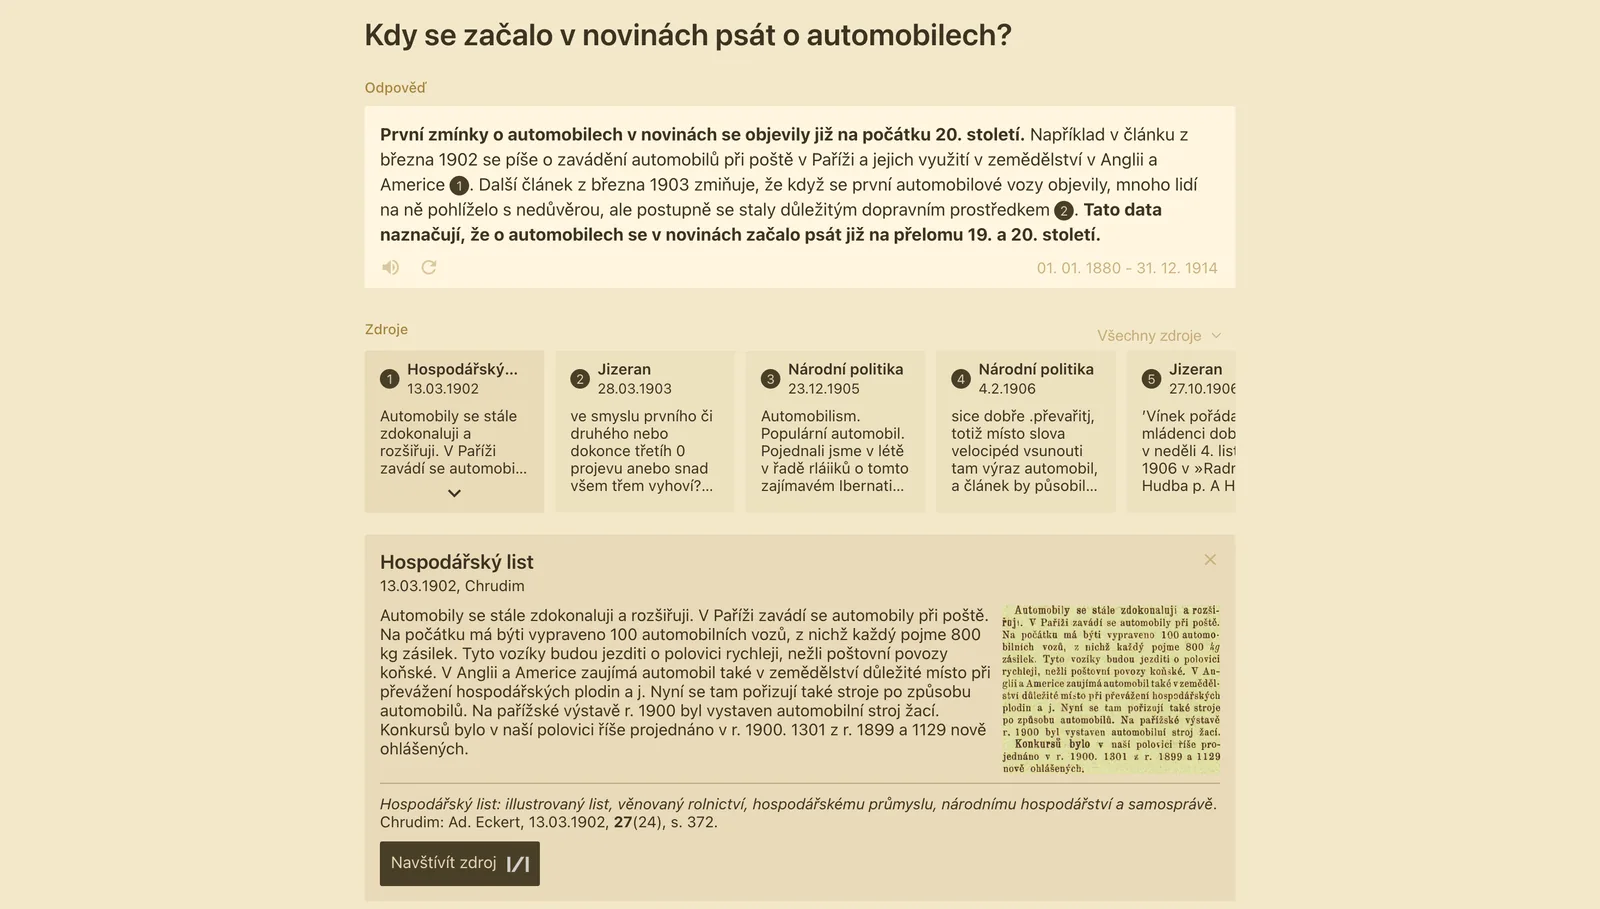
Naše řešení využívá technologii vektorové indexace a AI k tomu, aby systém dokázal odpovědět na konkrétní dotazy uživatele a zároveň poskytl přímé zpětné odkazy na zdrojové dokumenty (konkrétní sken z digitální knihovny). Integrace umělé inteligence (LLM) zajišťuje přesnější výsledky vyhledávání i při neúplných nebo nepřesných dotazech.
Paměť novin nehledá jen slova, ale interpretuje obsah článků, dokáže sumarizovat dlouhé texty a propojovat události napříč různými tituly novin. Tímto způsobem transformujeme statický digitální archiv v aktivního průvodce historií, který dokáže identifikovat klíčová témata a trendy v čase bez nutnosti složitého zaučování uživatele.
Ostatně, vyzkoušejte to sami: www.pametnovin.cz
Využití sémantického dotazování ve firemní praxi
Jádro aplikace, postavené na vektorové indexaci a velkých jazykových modelech (LLM), umožňuje efektivní práci s rozsáhlými soubory nestrukturovaných dokumentů. Namísto statického webu nebo nespolehlivého chatbota získáte systém, který interpretuje význam dotazu v přirozeném jazyce a odpovědi okamžitě dokládá citací z konkrétního vnitrofiremního zdroje.
A kde najde tato technologie uplatnění?
- Správa firemního know-how: okamžitý přístup k informacím v tisících smluv, směrnic nebo technických listů bez nutnosti manuálního vyhledávání.
- Inteligentní zákaznická podpora: webová prezentace, která zákazníkovi skutečně odpoví na dotaz k produktu nebo službě na základě celé historie vašich dokumentů.
- Datová autonomie managementu: možnost analyzovat obsah archivů a hledat souvislosti v datech samostatně, bez čekání na přípravu skriptů od IT oddělení.
- Zpracování odborných textů: efektivní rešerše v archivech judikátů, projektových dokumentací nebo medicínských studií, kde selhává vyhledávání podle klíčových slov.
Blog
O Paměti novin jsme už psali – pokud vás projekt zajímá víc, můžete si o něm přečíst na našem blogu: