ENG


V článku ukazujeme pět míst, kde se práce s daty typicky zadrhává – a konkrétní řešení, která jsme na těchto principech postavili.
Hodně dat. V katalozích, digitálních knihovnách, tabulkách, lokálních databázích, úložištích a často pořád i v papírových kartách a šanonech. Každý zdroj vznikal v jinou dobu, pro jiný účel a podle jiných pravidel. Ve chvíli, kdy potřebujete dohledat souvislost, zkontrolovat tisíce záznamů nebo zpracovat větší objem materiálu, začíná skutečná práce. Přepínání mezi systémy, exporty, ruční kontrola, přepisování údajů a hledání způsobu, jak celý proces udržet pod kontrolou.
Za více než patnáct let práce s knihovnami a dalšími paměťovými institucemi se setkáváme s podobnými situacemi opakovaně. Princip bývá podobný. Systém převezme opakovatelnou část procesu. Odborník řeší výjimky, kontext a rozhodnutí, pro která jsou důležité jeho zkušenosti.
Principy, které jsme se v tomto prostředí naučili, dokážeme aplikovat všude tam, kde je potřeba lépe pracovat s rozsáhlými daty, dokumenty, obrazovým materiálem nebo odborným know-how. V článku ukazujeme pět míst, kde se práce s daty typicky zadrhává – a konkrétní řešení, která jsme na těchto principech postavili.
Katalog. Digitální knihovna. Excel. Lokální databáze. Evidenční systém. Obrazové úložiště. Papírová dokumentace. V jednom systému zjistíte, že dokument existuje. V dalším ověříte jeho digitalizaci. Jinde hledáte metadata, identifikátor nebo informaci o tom, co se se záznamem dělo. Odpověď na jedinou otázku tak může vznikat skládáním informací z několika zdrojů.
Na začátku proto mapujeme, kde potřebná data vznikají, jakou mají strukturu, v jaké jsou kvalitě a jak se k nim dá bezpečně přistupovat. Nad relevantními zdroji pak může vzniknout společná pracovní vrstva pro vyhledávání, filtrování, kontrolu a propojování souvislostí. Podle situace pracuje s jednorázovým exportem, pravidelně aktualizovanými daty nebo přímým napojením.
Právě z podobné potřeby vznikl Anakon.
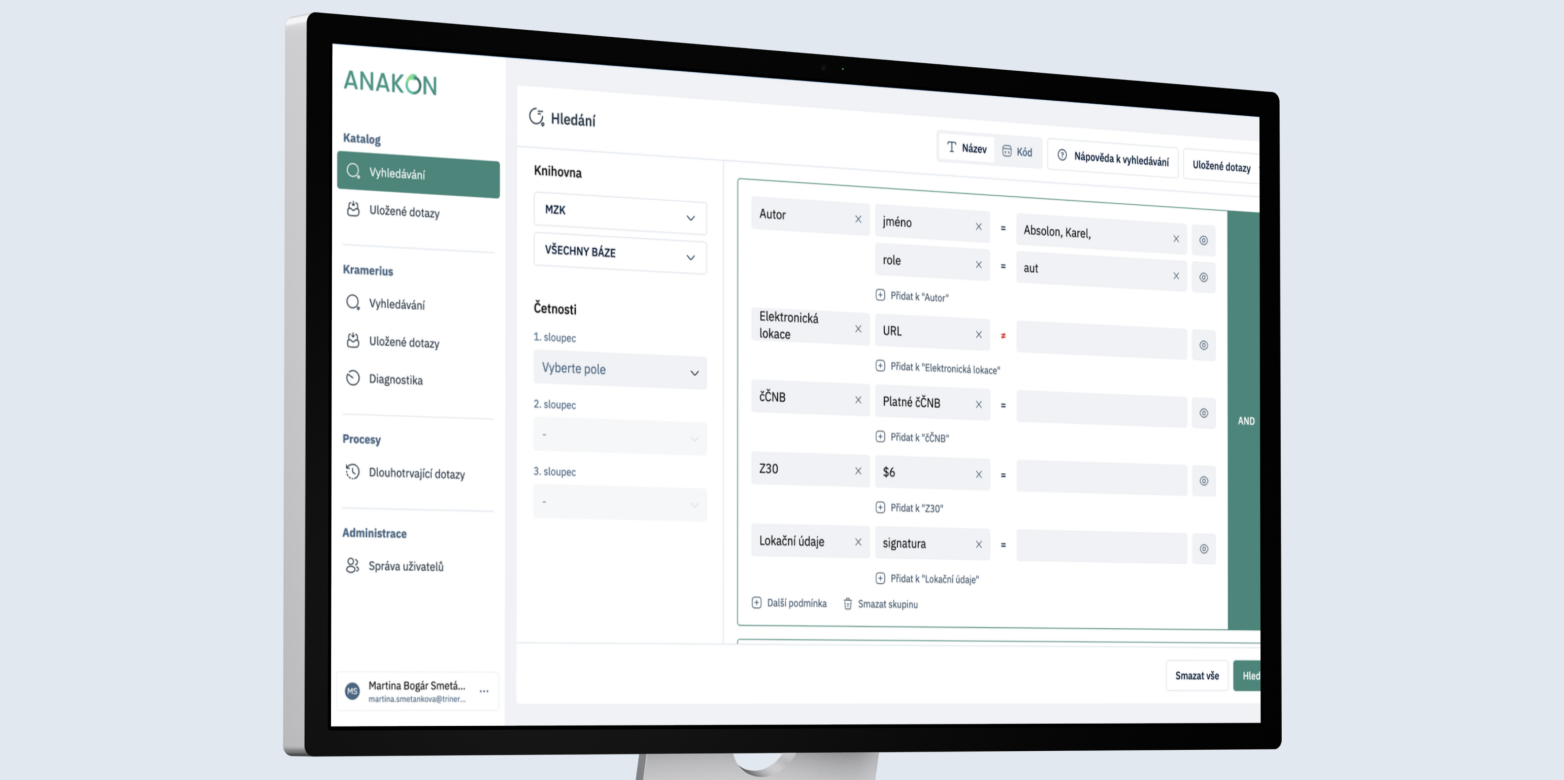
V současnosti Anakon pracuje například s daty ve formátech MARC 21, MODS a indexy digitální knihovny Kramerius. Umožňuje také porovnávat údaje mezi katalogem a Krameriem. Konkrétní řešení lze rozšířit na jiné formáty a zdroje podle potřeb projektu např. UNIMARC. Důležitý je princip – umožnit odborníkům analyzovat, kontrolovat a propojovat data bez ohledu na to, v jakém systému původně vznikla.
Představte si například kontrolu fondu před dalším krokem digitalizace. Potřebujete najít záznamy s určitou kombinací polí, zjistit, kde něco chybí, nebo porovnat informace z několika zdrojů. Anakon umožní takový dotaz připravit a nad daty ho opakovaně spouštět. Odborník tak získává pracovní nástroj nad daty, která už instituce má, a může s nimi pracovat v širších souvislostech.
U deseti snímků se dá řada věcí opravit ručně. U desetitisíců nebo statisíců stran začíná mít každé kliknutí svoji cenu. Dobře je to vidět při zpracování obrazů v digitalizační lince. Strany je potřeba rozpoznat, správně oříznout, natočit a zkontrolovat. Velká část materiálu přitom prochází velice podobným procesem. Právě tady vzniká prostor pro automatizaci.
Cropilot pomocí AI modelu vyhodnotí obrazová data, rozpozná stránky a připraví jejich ořez a natočení. Výsledek může pracovník zkontrolovat v editačním rozhraní a věnovat pozornost případům, které vyžadují zásah. Čas odborníka se tak soustředí tam, kde přináší největší hodnotu, a to na kontrolu kvality a řešení výjimek.
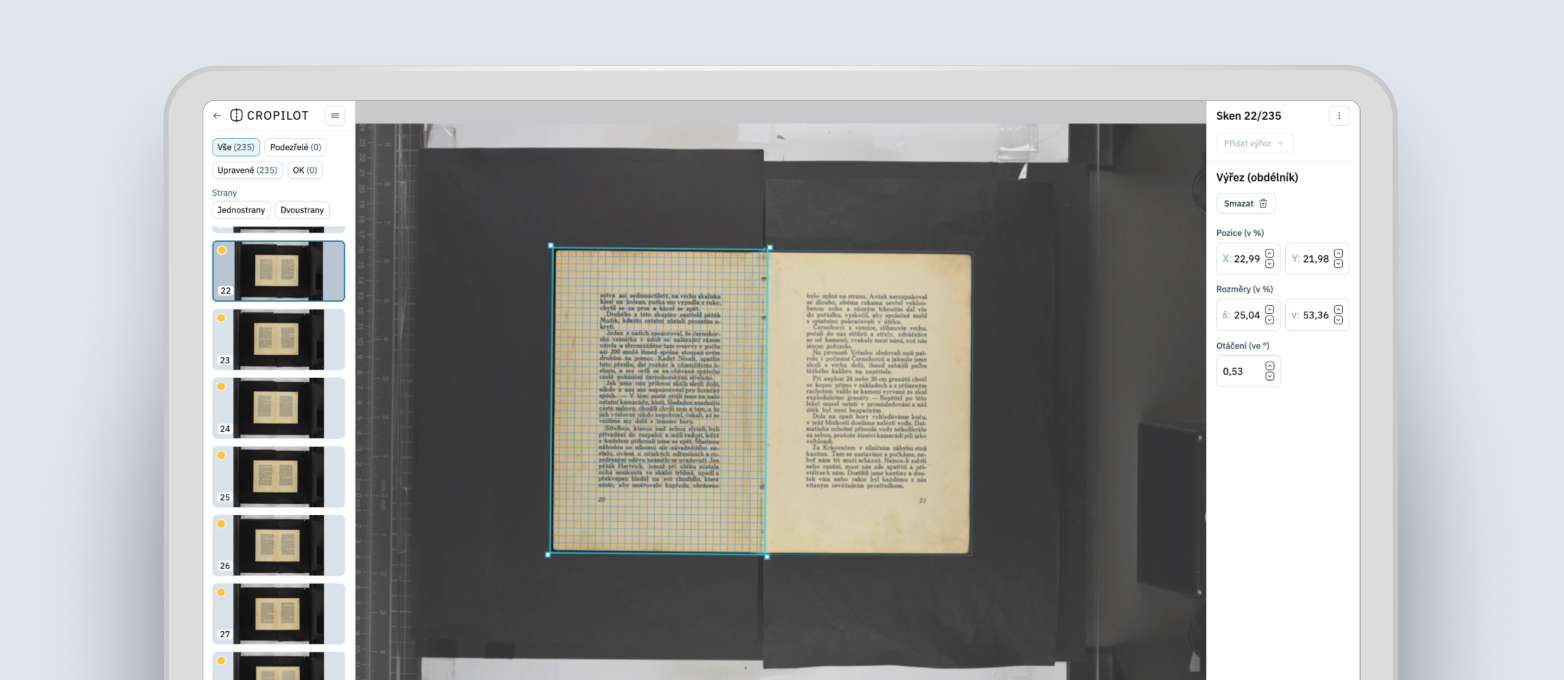
Historické tisky, noviny, kartotéky nebo osobní dokumenty mohou mít odlišné formáty, specifika i pravidla zpracování. Proto lze pracovat také s vlastními trénovacími daty a model přizpůsobit konkrétnímu materiálu.
Ve větším provozu může Cropilot zapadnout do existujícího digitalizačního workflow prostřednictvím integračního rozhraní. Pro menší pracoviště může fungovat jako samostatný nástroj. Automatizace v tomto případě řeší technický krok a současně uvolňuje kapacitu lidí, kteří se mohou věnovat odbornější části digitalizačního procesu.
Katalogizace historických dokumentů vyžaduje zkušenost, znalost pravidel a schopnost pracovat s kontextem. Katalogizátor posuzuje titulní stranu, tiráž, autorství, vydavatelské údaje, autority, dobový jazyk i nejednoznačné informace. Vedle této odborné práce tráví čas pořizováním podkladů, přepisováním údajů a dohledáváním možných shod v dalších databázích.
Právě tuto přípravnou část zkoušíme zrychlit pomocí AI katalogizace.
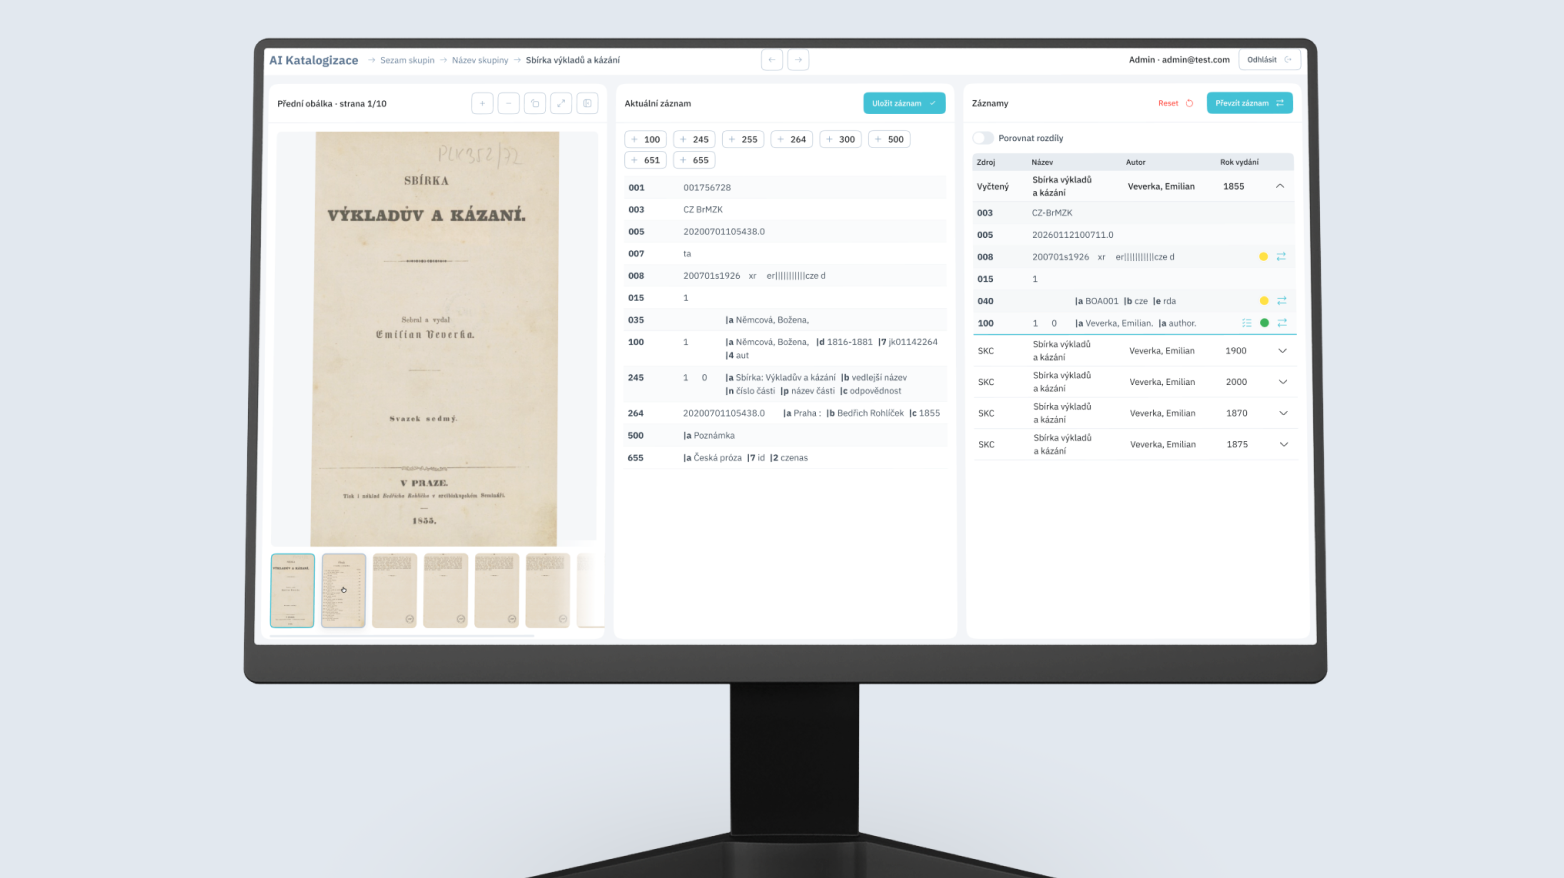
Z fotografií titulní strany, tiráže, obálky a dalších důležitých částí dokumentu systém vytěží bibliografické údaje, zpracuje je a připraví návrh záznamu ve formátu MARC 21.
Součástí procesu je práce s autoritními databázemi a existujícími záznamy v katalozích. Systém připraví možné varianty a podklady, ze kterých může katalogizátor při rozhodování vycházet. Každý údaj může zkontrolovat, upravit nebo doplnit. Role AI je v tomto workflow jasně vymezená. Zpracuje mechanickou část přípravy a vytvoří kvalitní výchozí bod. Odborné posouzení a odpovědnost zůstávají u katalogizátora.
Nástroj nyní rozvíjíme a ověřujeme společně s katalogizátory z Moravské zemské knihovny. Jejich zkušenost nám pomáhá ladit rozhraní i jednotlivé kroky podle skutečné katalogizační praxe. Současně zjišťujeme, ve kterých typech dokumentů a situacích přináší asistovaná katalogizace největší hodnotu.
Instituce často používá standardní centrální systémy, které dobře zajišťují svou hlavní agendu. Vedle nich postupně vznikají další potřeby specifické pro danou instituci, např.:
V takové situaci dává smysl vytvořit samostatnou vrstvu zaměřenou právě na daný úkol, pro snížení času, eliminaci ručních chyb nebo kvůli nedostatku kapacit.
Nejdřív zjišťujeme možnosti napojení. Podle systému může jít o API, databázi nebo datové exporty. Nad nimi pak vznikne pracovní rozhraní, ve kterém uživatel nastaví parametry, spustí úlohu, sleduje průběh a pracuje s výsledkem nebo je tento proces automatizovaný pomocí umělé inteligence.
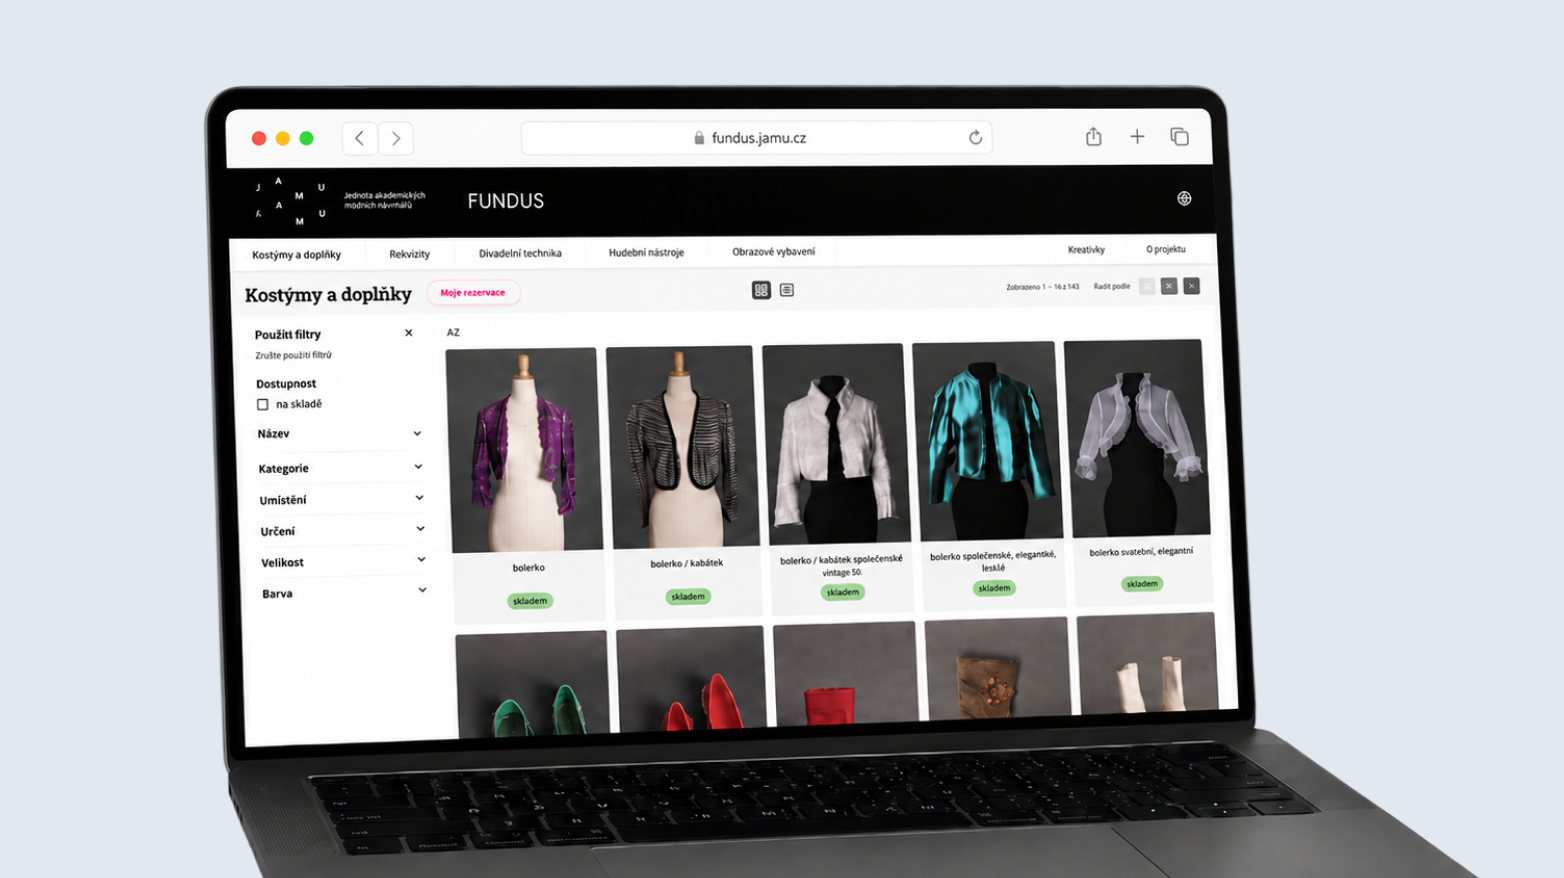
Dobře je tento princip vidět na Divadelním fundusu JAMU. Správci fundusu pracují s daty v Airtable, který znají ze svého každodenního provozu. Nad těmito daty jsme vytvořili webovou aplikaci, ve které studenti a zaměstnanci mohou procházet kostýmy, rekvizity, techniku nebo hudební nástroje, filtrovat je podle dostupných parametrů a vytvářet rezervace.
Jedna vrstva tak slouží lidem, kteří inventář spravují, a druhá těm, kteří v něm potřebují rychle něco najít a použít. Data přitom zůstávají součástí zavedeného pracovního prostředí.
Podobný princip využívá Statistický modul Krameria. Z provozních dat digitálních knihoven vytváří přehledné analytické pohledy, ve kterých lze návštěvnost sledovat například podle typu dokumentu, licence, roku vydání nebo autora. Nad existujícím systémem tak vzniká specializovaný nástroj pro konkrétní potřebu instituce.
Stejná logika se promítá do dalších nástrojů pro metadata, digitalizačních workflow i řešení nad digitálními knihovnami. Hlavní systém dál zajišťuje agendu, pro kterou vznikl. Specializovaná vrstva řeší konkrétní proces, který pracovník potřebuje zvládnout rychleji, přehledněji nebo ve větším objemu.
Badatel, student nebo návštěvník obvykle přichází s tématem, místem, autorem nebo přibližnou představou toho, co hledá. Interní struktura fondu pracuje s přesnější terminologií, katalogizačními pravidly a metadaty. Historické dokumenty navíc přidávají dobový jazyk, rozdílný pravopis a kvalitu OCR.
Dobré zpřístupnění proto propojuje dvě různé perspektivy:
Sladit obě potřeby v jednom prostředí bývá důležitou součástí návrhu, zvlášť u systémů, se kterými pracují odborníci i veřejnost. Nad fondy tak stavíme prezentační a vyhledávací vrstvy podle toho, kdo s obsahem pracuje a co od něj potřebuje.
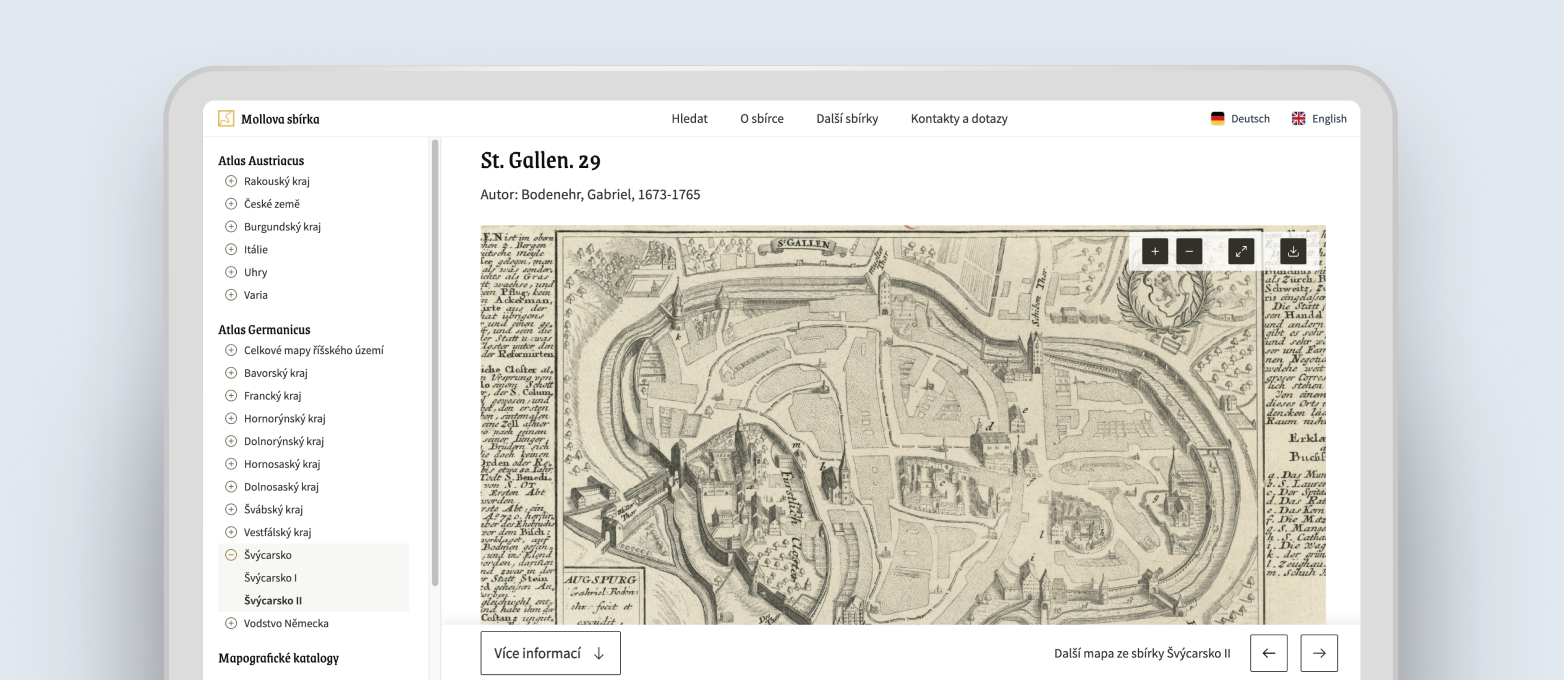
Jednotlivé sbírky přitom mohou vyžadovat úplně jiný způsob objevování. U Mollovy sbírky vzácných map hraje hlavní roli obraz, geografický kontext a možnost studovat mapy a veduty ve vysokém rozlišení. Uživatel může sbírku procházet podle území, autora nebo období a pracovat s ní jako s digitálním badatelským prostředím.
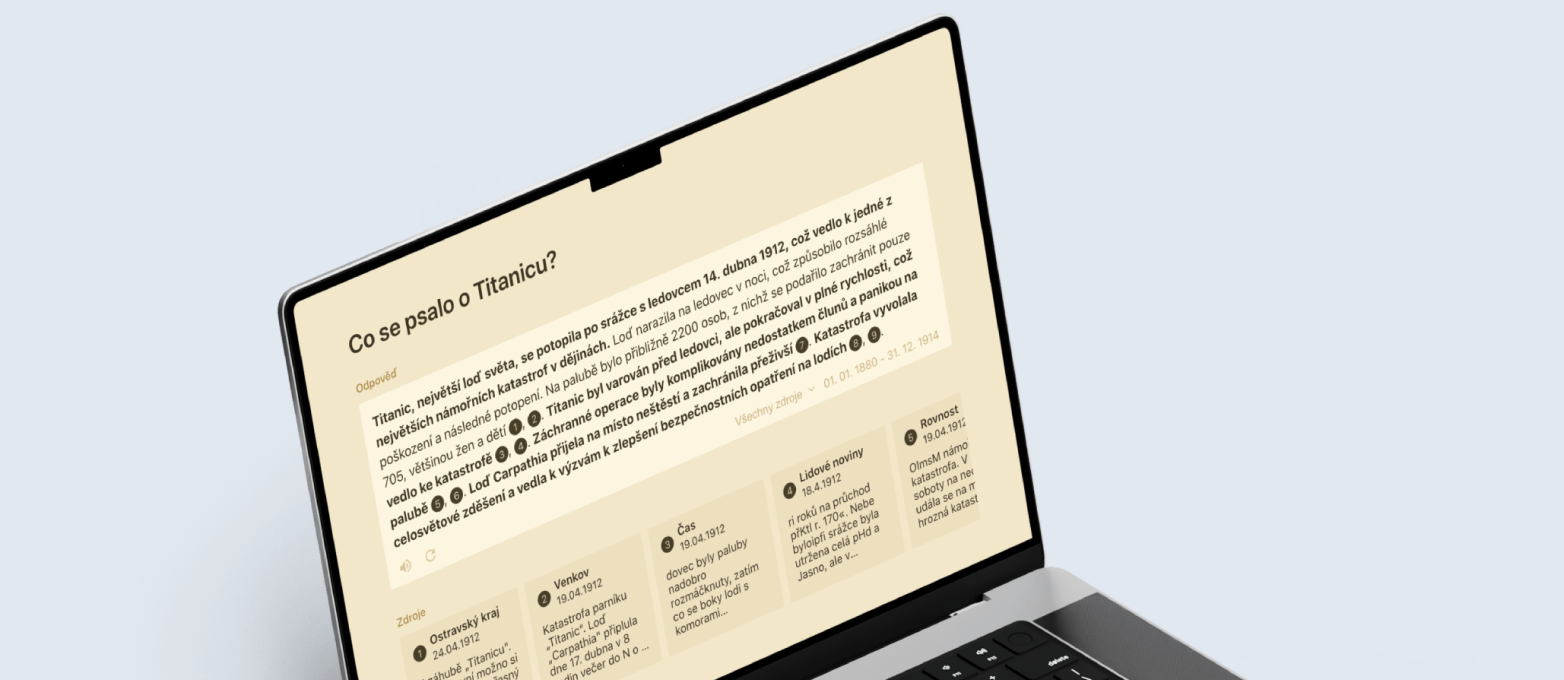
U historických novin řeší jiný problém Paměť novin. Sémantické vyhledávání umožňuje položit otázku přirozeným jazykem, pracovat s významem textu a dohledat zdrojové dokumenty, ze kterých odpověď vychází. U historických materiálů je to užitečné také tam, kde klasické hledání komplikuje dobová terminologie nebo kvalita OCR.
Pro digitální knihovnu Kramerius dlouhodobě navrhujeme a vyvíjíme webového klienta – od návrhu nových funkcí, přes vývoj (primárně frontend), až po integraci umělé inteligence, která posouvá práci s daty na zcela novou úroveň.
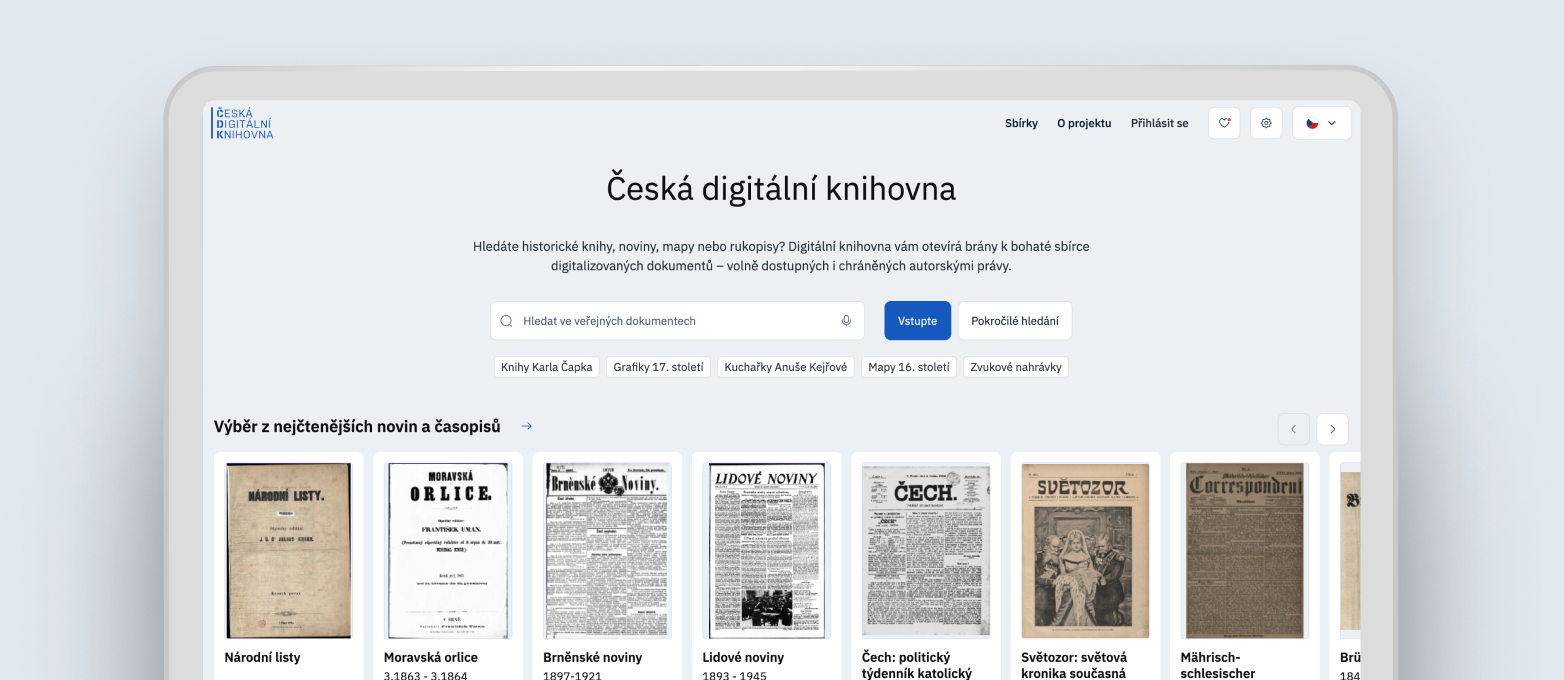
Technologie tím zkracuje cestu mezi člověkem a obsahem. Uživatel může rychleji najít relevantní dokument, objevit související materiál a pokračovat v rešerši směrem, který odpovídá jeho skutečnému zájmu.
Cropilot, Anakon, AI katalogizace, Divadelní fundus JAMU, nástroje nad digitálními knihovnami i prezentační projekty pro jednotlivé sbírky vznikly z rozdílných situací.
Způsob, jakým nad nimi přemýšlíme, je podobný. Začínáme u konkrétního procesu a lidí, kteří s ním pracují každý den. Zjišťujeme, které kroky se opakují, kde vznikají chyby, co zabírá nejvíc času a která rozhodnutí potřebují odborný kontext. Pracujeme s reálnými daty včetně historických vrstev, výjimek a lokálních specifik. A vždy se soustředíme na to, co je pro danou instituci skutečně specifické.
Výsledek, který hledáme, zůstává stejný – méně ruční práce, více kontroly a data, fondy i sbírky, se kterými se dá skutečně pracovat.
Pro první rozhovor s námi stačí popsat konkrétní proces, který dnes zabírá příliš mnoho času, končí v tabulkách nebo pravidelně naráží na limity současných nástrojů. Podíváme se, zda pro něj dává smysl některý z našich produktů, specializovaná nadstavba, práce nad daty nebo rychlý pilot na reálném vzorku dat.
Proberte s námi konkrétní problém vaší instituce. Napište našemu CEO Honzovi Rychtářovi na jan.rychtar@trinera.cz nebo využijte formulář níže.